

As melhores IAs locais para conversar em português do Brasil em 2026 incluem o Qwen 3.5 9B, uma escolha equilibrada para PCs intermediários; o Gemma 4 12B, interessante para quem também pretende analisar imagens; e o Ministral 3 8B, outra alternativa multilíngue. Para computadores com menos memória, vale começar pelo Qwen 3.5 4B. Já quem tem uma máquina mais potente pode experimentar gpt-oss 20B e Qwen 3.6 27B.
Tópicos
- Qual IA local escolher? Veja a resposta rápida
- Tabela: 7 modelos de IA local para conversar em português
- O que é IA local e qual a diferença entre modelo e aplicativo?
- Melhores IAs locais em português: vantagens de cada modelo
- 1. Qwen 3.5 9B: uma escolha equilibrada para conversar em português
- 2. Qwen 3.5 4B: para quem tem um computador mais simples
- 3. Gemma 4 12B: opção para texto e interpretação de imagens
- 4. Ministral 3 8B: alternativa multilíngue para o uso cotidiano
- 5. DeepSeek-R1 8B: para perguntas que exigem raciocínio
- 6. gpt-oss 20B: raciocínio local para quem tem mais memória
- 7. Qwen 3.6 27B: para computadores potentes e tarefas técnicas
- Quantos GB de RAM e VRAM são necessários para rodar IA local?
- Quais são os melhores programas para conversar com uma IA local?
- LM Studio: interface simples para baixar modelos e abrir um chat
- Ollama: modelos pelo terminal e também por aplicativo
- Jan: alternativa aberta com interface de chat
- GPT4All: alternativa para conversar com documentos locais
- Open WebUI: conversa pelo navegador usando um modelo local
- Como instalar uma IA local grátis e conversar em português
- Opção 1: passo a passo pelo LM Studio, sem comandos
- Opção 2: passo a passo pelo Ollama no Windows, macOS ou Linux
- Como fazer a IA responder em português do Brasil, sem soar traduzida?
- Vale a pena trocar uma IA online por uma IA local?
- Cuidados com privacidade, downloads e segurança
- Perguntas frequentes sobre IA local em português
- Existe uma IA semelhante ao ChatGPT que funciona sem internet?
- Qual IA local usar em um PC com apenas 8 GB de RAM?
- Preciso de uma placa de vídeo NVIDIA para usar IA local?
- Qual modelo local entende melhor gírias e expressões brasileiras?
- É possível enviar PDFs para uma IA local?
- Ollama e LM Studio são gratuitos?
- Qual é a diferença entre 4B, 9B, 20B e 27B?
- Afinal, qual IA local escolher em 2026?
- Como esta seleção foi feita
Esses modelos podem ser instalados no próprio computador e usados sem conexão com a internet depois do download e da configuração. Você não precisa enviar cada pergunta a um servidor externo para obter uma resposta. A qualidade do português, porém, varia com o modelo, a versão, o tamanho e as instruções utilizadas.
Este guia do Overdrive compara sete opções disponíveis para execução local, mostra o espaço aproximado dos arquivos, explica quanto de RAM considerar e ensina a começar pelo LM Studio ou pelo Ollama. As recomendações são uma seleção editorial baseada em documentação e características oficiais — não são o resultado de um benchmark próprio de fluência em português brasileiro.
Qual IA local escolher? Veja a resposta rápida
- Para começar, com 8 GB de RAM: Qwen 3.5 4B, mantendo outras aplicações fechadas e um contexto de conversa pequeno.
- Para um PC de 16 GB de RAM: Qwen 3.5 9B, indicado como primeiro teste para conversas gerais em português.
- Para conversar e analisar imagens: Gemma 4 12B, desde que haja memória disponível e o aplicativo aceite anexos visuais.
- Para comparar outra família multilíngue: Ministral 3 8B, que oferece suporte declarado a português.
- Para lógica e raciocínio: DeepSeek-R1 8B em máquinas intermediárias ou gpt-oss 20B em computadores com mais memória.
- Para um PC mais forte: Qwen 3.6 27B, especialmente se o uso também incluir programação e tarefas técnicas.
Se a sua dúvida é sobre alternativas na nuvem, vale consultar nosso comparativo de IAs em 2026. A diferença aqui é que o processamento principal ocorre no seu dispositivo.
Tabela: 7 modelos de IA local para conversar em português
| Modelo | Indicação | Download aproximado* | PC sugerido** |
|---|---|---|---|
| Qwen 3.5 4B | PC básico e textos curtos | 3,3 a 4 GB | 8 GB de RAM, com ressalvas |
| Qwen 3.5 9B | Conversas e escrita em geral | 6,6 a 7,6 GB | 16 GB de RAM |
| Gemma 4 12B | Texto, imagens e instruções complexas | 7,7 a 8 GB | 16 a 24 GB de RAM |
| Ministral 3 8B | Diálogo multilíngue e imagens | 6 GB | 16 GB de RAM |
| DeepSeek-R1 8B | Problemas com várias etapas | 5,2 GB | 16 GB de RAM |
| gpt-oss 20B | Raciocínio mais elaborado | 14 GB | 24 a 32 GB de RAM, preferencialmente |
| Qwen 3.6 27B | PC potente e tarefas técnicas | 18 a 19 GB | 32 GB de RAM ou mais |
* Tamanhos de arquivos exibidos no catálogo oficial do Ollama, consultado em 9 de outubro de 2026; podem mudar conforme a versão e a quantização. ** Faixas de RAM são estimativas editoriais conservadoras para iniciar testes, não requisitos mínimos certificados. O modelo carregado também consome memória com o contexto da conversa, o sistema operacional e outros processos. Uma GPU com VRAM suficiente pode acelerar as respostas, mas não é obrigatória em todas as configurações.
O que é IA local e qual a diferença entre modelo e aplicativo?
Uma IA local é um modelo de inteligência artificial executado no seu computador, em vez de ser consultado exclusivamente pela internet. Isso permite conversar, revisar textos, resumir informações e trabalhar com determinados documentos sem enviar automaticamente o conteúdo para um serviço externo — desde que o aplicativo esteja configurado para usar um modelo realmente local.
Há duas peças diferentes nesse processo. Qwen, Gemma, DeepSeek e gpt-oss são modelos: são eles que interpretam a pergunta e geram o texto. LM Studio, Ollama, Jan e GPT4All são aplicativos ou ambientes que ajudam a baixar, carregar e utilizar esses modelos. O Open WebUI, por sua vez, pode servir como interface de conversa conectada a um servidor local.
Esse detalhe também muda a privacidade: usar o Ollama ou o Jan não garante trabalho offline se você selecionar um modelo hospedado na nuvem. Confira sempre o provedor e o nome da variante selecionada.
Melhores IAs locais em português: vantagens de cada modelo
1. Qwen 3.5 9B: uma escolha equilibrada para conversar em português
O Qwen 3.5 9B é o ponto de partida sugerido para quem dispõe de um PC com 16 GB de RAM e pretende manter conversas frequentes, produzir rascunhos, reorganizar informações e pedir explicações. A família Qwen 3.5 declara suporte a 201 idiomas e dialetos, além de combinar texto e visão em seus modelos.
A cobertura multilíngue torna a família uma candidata relevante para testar português do Brasil, mas não é uma garantia de que cada resposta utilizará naturalmente expressões brasileiras. Para esse objetivo, dê instruções claras e confira o resultado em situações reais.
Para instalar no Ollama: ollama run qwen3.5:9b. Consulte a ficha oficial e as variantes do Qwen 3.5.
2. Qwen 3.5 4B: para quem tem um computador mais simples
O Qwen 3.5 4B ocupa menos espaço do que o 9B e pode fazer mais sentido em máquinas com 8 GB de RAM. É uma opção para conversar, corrigir frases, reescrever mensagens e criar resumos curtos, sobretudo quando a velocidade e o consumo de memória importam mais do que a complexidade da resposta.
O compromisso é que um modelo pequeno pode perder detalhes em solicitações extensas, cometer mais erros ou ter dificuldade para manter o contexto de muitos turnos. Em PCs sem placa de vídeo dedicada, também é possível que a geração de texto seja lenta.
Comando: ollama run qwen3.5:4b. Se ainda ficar pesado, há variantes menores como qwen3.5:2b, mas a qualidade tende a exigir ainda mais revisão.
3. Gemma 4 12B: opção para texto e interpretação de imagens
O Gemma 4 12B, do Google DeepMind, combina recursos de conversação, raciocínio e compreensão visual. É uma opção interessante para quem deseja fazer perguntas sobre uma imagem, discutir um gráfico ou complementar a conversa com capturas de tela. Isso depende de usar um aplicativo e um formato de entrada compatíveis.
O arquivo disponibilizado pelo Ollama tem aproximadamente 7,7 a 8 GB. Por isso, 16 GB de RAM podem ser um ponto de partida em condições favoráveis, mas 24 GB ou mais oferecem folga quando o sistema já utiliza muita memória ou a conversa é longa.
Comando: ollama run gemma4:12b. Veja as variantes oficiais do Gemma 4. A família também oferece E2B e E4B, voltadas a dispositivos de menor porte, mas o consumo exato depende da implementação.
4. Ministral 3 8B: alternativa multilíngue para o uso cotidiano
O Ministral 3 8B, da Mistral AI, é uma opção para comparar estilos de resposta sem sair do universo local. A documentação informa suporte a dezenas de idiomas, incluindo português, e a família também aceita entradas visuais em ambientes compatíveis.
Ele pode ser experimentado para redação, perguntas gerais e interpretação de instruções. Como a naturalidade do português varia entre perguntas, o ideal é compará-lo ao Qwen usando exatamente os mesmos comandos, sem assumir que uma resposta boa prova superioridade geral.
Comando: ollama run ministral-3:8b. Confira a documentação do Ministral 3.
5. DeepSeek-R1 8B: para perguntas que exigem raciocínio
O DeepSeek-R1 8B é uma versão menor, destilada para tarefas de raciocínio. Ele é uma opção para testar problemas de lógica, planejamento com restrições e explicações que exigem várias etapas.
O catálogo do Ollama identifica a variante de 8 bilhões de parâmetros como DeepSeek-R1-0528-Qwen3-8B, e seu arquivo ocupa cerca de 5,2 GB. Como nos outros modelos, raciocinar por mais etapas não impede erros: verifique cálculos, citações e fatos antes de utilizá-los.
Comando: ollama run deepseek-r1:8b. A página oficial explica a diferença entre versões destiladas e o modelo original de grande porte.
6. gpt-oss 20B: raciocínio local para quem tem mais memória
O gpt-oss 20B é o modelo de pesos abertos da OpenAI desenvolvido para tarefas de raciocínio, uso de ferramentas e aplicações personalizáveis. No Ollama, a distribuição ocupa aproximadamente 14 GB e utiliza quantização MXFP4.
Segundo a documentação oficial, o modelo pode funcionar em sistemas com 16 GB de memória, mas essa é uma condição bastante apertada para quem também utiliza o sistema operacional e outros programas. Para sessões confortáveis e margens de contexto maiores, este guia sugere considerar 24 a 32 GB de RAM ou mais.
Comando: ollama run gpt-oss:20b. Consulte a ficha oficial do modelo. Atenção: executar gpt-oss localmente não é a mesma coisa que instalar o aplicativo ChatGPT para uso offline.
7. Qwen 3.6 27B: para computadores potentes e tarefas técnicas
O Qwen 3.6 27B é uma alternativa para usuários com bastante memória e que, além de conversar, desejam discutir código ou resolver tarefas mais exigentes. A documentação da família Qwen 3.6 enfatiza melhorias em programação com agentes e manutenção do contexto de raciocínio.
A versão 27B aparece no Ollama com download aproximado de 18 a 19 GB. Para começar, é mais realista pensar em 32 GB de RAM ou mais do que tentar instalá-lo em um notebook básico. Se a prioridade for apenas trocar mensagens curtas, um modelo menor provavelmente terá melhor tempo de resposta.
Comando: ollama run qwen3.6:27b. Veja a página oficial do Qwen 3.6. Quem tiver esse nível de hardware também pode comparar o qwen3.5:27b, sem presumir que a geração mais nova vença em todas as tarefas de português.
Quantos GB de RAM e VRAM são necessários para rodar IA local?
Não existe uma única exigência de memória para todas as IAs locais. O consumo depende do arquivo escolhido, da quantização (forma de reduzir o tamanho dos pesos), do tamanho da conversa, do programa utilizado e de quanto do processamento fica na GPU ou no processador.
| Seu computador | Por onde começar | O que esperar |
|---|---|---|
| 8 GB RAM, sem GPU dedicada | Qwen 3.5 2B ou 4B | Conversas curtas; possíveis lentidão e falta de memória |
| 16 GB RAM | Qwen 3.5 9B, Ministral 3 8B ou DeepSeek-R1 8B | Mais variedade de tarefas, desde que o contexto caiba |
| 24 a 32 GB RAM | Gemma 4 12B ou gpt-oss 20B | Mais margem para modelos e conversas exigentes |
| 32 a 64 GB RAM ou configuração com GPU robusta | Qwen 3.5/3.6 27B | Modelos maiores, com demanda maior de processamento |
RAM e VRAM não são a mesma coisa. A RAM é a memória principal do sistema. A VRAM fica na placa de vídeo dedicada; em máquinas com GPU integrada ou memória unificada, a organização muda. Ter mais VRAM ajuda a manter partes maiores do modelo na GPU, mas velocidade depende também do chip, da largura de banda e do restante da configuração.
Um arquivo de 7 GB, portanto, não significa que apenas 7 GB de RAM sejam suficientes. Além dos pesos do modelo, existe o cache de contexto e o consumo de memória de todo o sistema. O próprio LM Studio recomenda 16 GB ou mais de RAM em várias de suas plataformas. Se você está em dúvida sobre a diferença entre memória gráfica e desempenho, o Overdrive também explica o papel de 8 GB de VRAM em jogos — uma carga de trabalho distinta, mas útil para entender o que é memória de vídeo.
Quais são os melhores programas para conversar com uma IA local?
LM Studio: interface simples para baixar modelos e abrir um chat
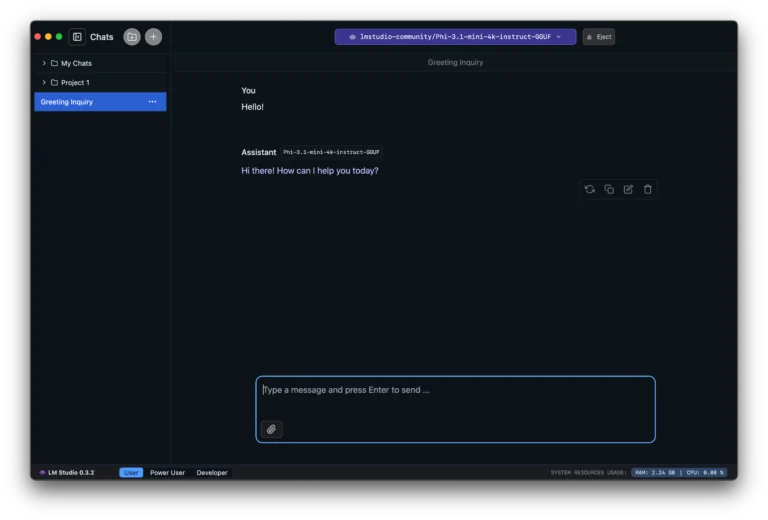
Para quem quer instalar uma IA sem depender do terminal, o LM Studio é um dos caminhos mais diretos. Ele permite procurar modelos, baixar arquivos compatíveis, carregá-los na memória e conversar por uma interface própria. A documentação também descreve conversas com documentos e uso de um servidor local.
É possível instalar LM Studio em versões compatíveis de Windows, Linux e macOS com Apple Silicon. No Windows x64, verifique o suporte a AVX2; em Macs antigos com processador Intel, confira as restrições antes de tentar instalar. Consulte os requisitos oficiais.
Ollama: modelos pelo terminal e também por aplicativo
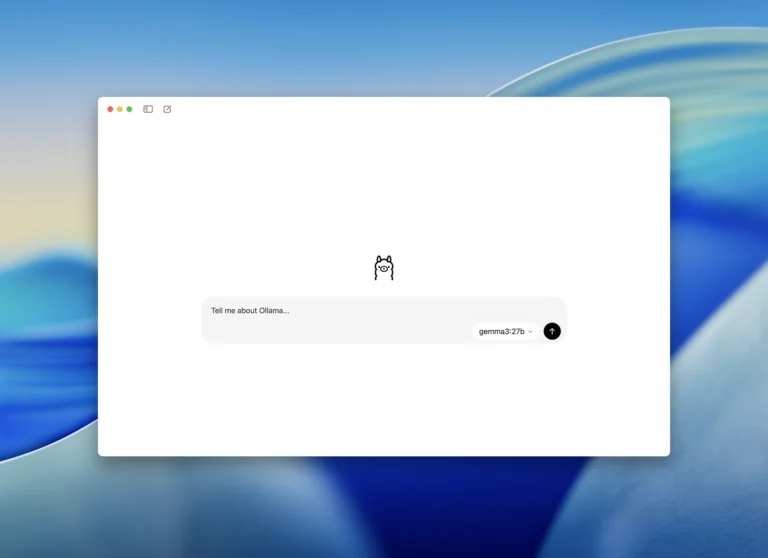
O Ollama é bastante prático para quem deseja reproduzir a mesma instalação ou testar modelos com comandos simples. E ele não se limita ao terminal: versões para Windows e macOS oferecem um aplicativo para baixar modelos e conversar, segundo a documentação de lançamento da interface. No Linux, o uso por linha de comando continua sendo um caminho comum.
O programa também serve como base para conectar uma IA local a outras interfaces e ferramentas. Se o objetivo é manter tudo no próprio computador, evite escolher variantes que terminem em :cloud ou habilitar integrações externas sem necessidade.
Jan: alternativa aberta com interface de chat
O Jan oferece uma interface de conversa com modelos locais e opções de conexão a serviços online. Por reunir os dois caminhos, confira se o modelo selecionado está marcado como on-device ou local quando o objetivo for trabalhar offline. Atenção: em versões atuais, a busca na web pode vir ativada por padrão. Para uma conversa estritamente offline, desative o recurso de pesquisa na internet e outras integrações externas, além de conferir o provedor do modelo; veja a documentação do Jan.
GPT4All: alternativa para conversar com documentos locais
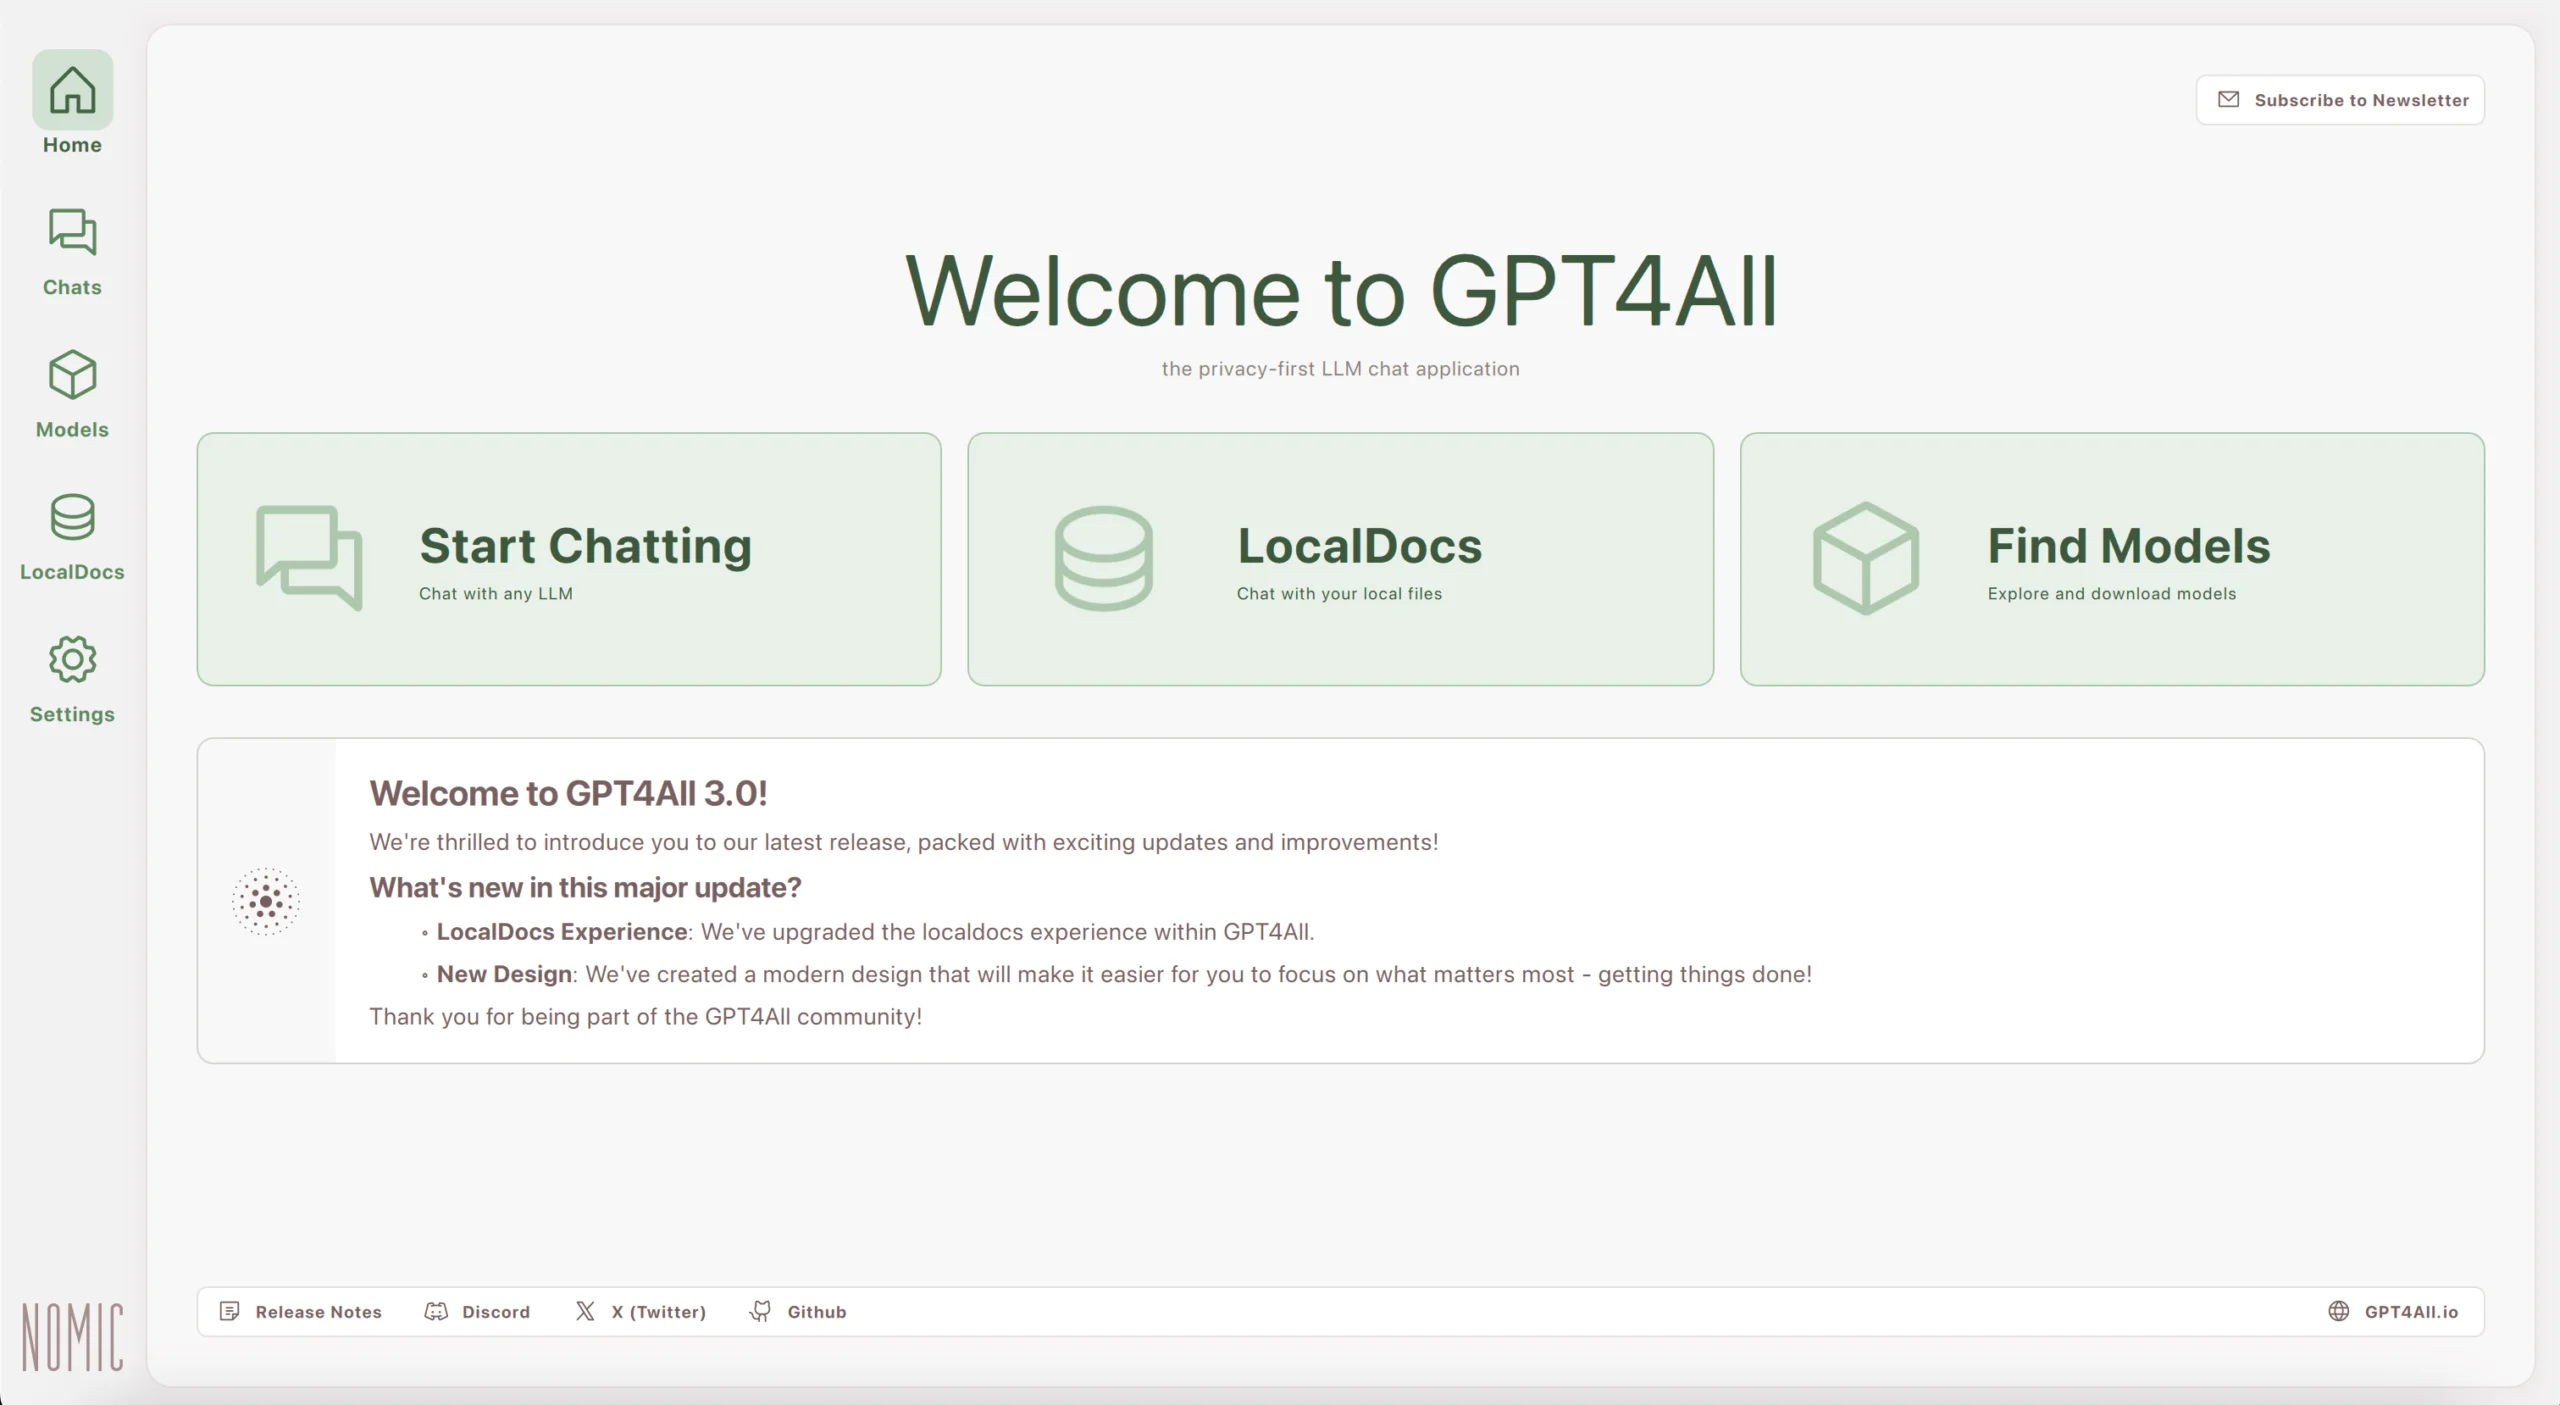
O GPT4All, da Nomic, é outra opção para quem prefere um programa com janelas e menus. Entre os recursos documentados está o LocalDocs, voltado a consultas sobre arquivos armazenados no computador. É útil para quem pretende relacionar conversas a documentos sem enviar o material para um chatbot na nuvem.
Open WebUI: conversa pelo navegador usando um modelo local
Para quem prefere abrir o navegador e acessar uma interface semelhante à de um chatbot, o Open WebUI pode se conectar ao Ollama local. A instalação costuma exigir passos adicionais, como configurar Docker. É mais apropriado para quem deseja personalizar a experiência ou atender vários dispositivos dentro de uma rede controlada.
Como instalar uma IA local grátis e conversar em português
Opção 1: passo a passo pelo LM Studio, sem comandos
- Abra o site oficial do LM Studio e baixe o instalador compatível com seu sistema.
- Instale o programa e conclua a configuração inicial, incluindo a instalação do mecanismo de execução, quando solicitada.
- Acesse a área de descoberta de modelos (Discover) e procure por Qwen3.5 4B se o PC tiver pouca memória ou Qwen3.5 9B para começar em uma máquina de 16 GB.
- Selecione uma versão compatível com seu computador. Em downloads GGUF, variantes quantizadas em 4 bits podem consumir menos memória do que arquivos de precisão maior.
- Depois do download, abra a área Chat, carregue o modelo na memória e envie uma mensagem em português do Brasil.
- Para testar o funcionamento offline, desligue a internet e continue conversando com o modelo já instalado. Não dependa de recursos externos, como pesquisa online, nessa verificação.
O tutorial oficial do LM Studio detalha como baixar, carregar e iniciar conversas.
Opção 2: passo a passo pelo Ollama no Windows, macOS ou Linux
- Baixe e instale o Ollama.
- Abra o Terminal, PowerShell ou outro console disponível.
- Digite um dos comandos abaixo, conforme a memória do computador. O Ollama fará o download na primeira execução.
ollama run qwen3.5:4bPara um PC com mais memória:
ollama run qwen3.5:9bQuando o chat aparecer, experimente a primeira pergunta:
Responda em português brasileiro, com linguagem natural, frases claras e exemplos do cotidiano do Brasil. Explique a diferença entre memória RAM e VRAM para quem nunca montou um computador.
Para consultar os modelos baixados e os que estão ativos, utilize:
ollama list
ollama ps
Os exemplos usam variantes locais, e não versões remotas. Confira o guia oficial de instalação do Ollama se ocorrer algum erro.
Como fazer a IA responder em português do Brasil, sem soar traduzida?
Modelos multilíngues podem responder em português europeu, misturar expressões em inglês ou produzir um texto excessivamente formal. Vale definir o idioma e o estilo logo no primeiro pedido e, quando houver essa opção, salvar a instrução como system prompt no aplicativo.
Você é um assistente que escreve em português do Brasil. Use vocabulário, pontuação e construções naturais para leitores brasileiros. Evite termos típicos de Portugal quando existir uma opção comum no Brasil. Prefira frases claras e diretas. Não invente fontes, datas, estudos ou números. Quando não souber algo, admita a incerteza e diga como verificar.
Para comparar modelos, teste os mesmos pedidos em cada um deles. Alguns exemplos:
- Linguagem cotidiana: “Explique o que significa parcelar uma compra sem juros, sem usar juridiquês.”
- Escrita natural: “Reescreva este e-mail em português brasileiro profissional, mas sem formalidade excessiva.”
- Fidelidade: “Resuma o texto a seguir em cinco linhas, sem acrescentar informações que não apareçam nele.”
- Raciocínio: “Três amigos dividiram uma conta de R$ 90 igualmente. Um pagou R$ 10 a mais do que a sua parte. Quanto os outros dois precisam reembolsá-lo, juntos? Mostre o cálculo.”
Compare precisão, fluência, manutenção do contexto, tempo de resposta e respeito às instruções. Uma única pergunta não determina qual modelo é o melhor. Para conteúdo público ou profissional, revise todo o resultado e confirme os fatos em fontes independentes.
Vale a pena trocar uma IA online por uma IA local?
O maior atrativo da IA local é o controle sobre a execução. Depois da instalação, um modelo local pode continuar funcionando sem conexão, permite escolher versões específicas e evita enviar automaticamente cada mensagem a servidores de terceiros. Também não exige pagamento por mensagem em uma API para executar o modelo no seu próprio hardware.
O custo vem de outro lugar: armazenamento, eletricidade, memória e poder de processamento. Modelos pequenos podem responder com menos precisão, enquanto modelos grandes exigem hardware caro ou funcionam lentamente. Além disso, uma IA local não conhece notícias em tempo real por conta própria. Para pesquisar a web, ela precisaria de ferramentas adicionais, que normalmente dependem de conexão.
Aplicativos online seguem sendo mais práticos para tarefas que precisam de pesquisa atualizada, serviços conectados e recursos hospedados. Para comparar os limites das plataformas gratuitas, consulte o guia do Overdrive sobre como usar ChatGPT, Gemini e Claude sem pagar.
Cuidados com privacidade, downloads e segurança
- Baixe programas dos sites oficiais e confira a origem dos arquivos do modelo, especialmente em repositórios de terceiros.
- Verifique se o modelo é local. Algumas interfaces também permitem usar APIs e variantes em nuvem; nesse caso, o conteúdo pode ser processado fora do dispositivo.
- Não exponha a API local à internet sem necessidade e sem autenticação e controles de rede adequados. Um servidor local mal configurado pode ser acessado por terceiros.
- Consulte a licença do modelo. Ter pesos disponíveis para download não significa que todo o software seja de código aberto ou que todos os usos comerciais sejam permitidos sem condições.
- Não confie cegamente na resposta. Modelos locais também inventam fatos, erram contas e podem produzir citações inexistentes.
Perguntas frequentes sobre IA local em português
Existe uma IA semelhante ao ChatGPT que funciona sem internet?
Sim, há aplicativos como LM Studio, Ollama, Jan e GPT4All que permitem conversar com modelos instalados no computador. Eles oferecem uma experiência de chatbot, mas não são o próprio ChatGPT funcionando offline. É necessário baixar o modelo e os componentes necessários antes de desconectar a internet.
Qual IA local usar em um PC com apenas 8 GB de RAM?
Comece testando o Qwen 3.5 2B ou 4B. Mantenha o contexto da conversa pequeno e feche aplicações pesadas. O funcionamento e a velocidade dependem do processador, do sistema operacional e da memória livre; 8 GB não garantem uma experiência fluida.
Preciso de uma placa de vídeo NVIDIA para usar IA local?
Não necessariamente. É possível executar alguns modelos no processador, embora a resposta possa ser lenta. GPUs de fabricantes diferentes, Macs com memória unificada e configurações de CPU têm níveis distintos de suporte. Confira os requisitos do aplicativo e do formato do modelo antes de instalar.
Qual modelo local entende melhor gírias e expressões brasileiras?
Não há uma resposta universal sem testar os mesmos exemplos nas versões desejadas. O Qwen 3.5 9B é um bom ponto de partida pelo foco multilíngue da família, enquanto Ministral 3 8B e Gemma 4 12B são alternativas para comparação. Teste expressões do Brasil e confira se o modelo mantém o registro desejado.
É possível enviar PDFs para uma IA local?
Sim, aplicativos como LM Studio e GPT4All oferecem recursos de conversa com documentos. A capacidade real depende do programa, do processamento do arquivo e do modelo escolhido. Para documentos digitalizados como imagem, pode ser necessário um recurso de OCR ou um modelo visual compatível.
Ollama e LM Studio são gratuitos?
O Ollama pode ser usado para executar modelos locais gratuitamente. O LM Studio também oferece uso gratuito pessoal e profissional, segundo sua documentação. Isso não significa que todo modelo tenha a mesma licença, nem que serviços opcionais de nuvem sejam sempre gratuitos.
Qual é a diferença entre 4B, 9B, 20B e 27B?
Os números indicam, de forma aproximada, a quantidade de parâmetros dos modelos, expressa em bilhões. Em geral, variantes maiores exigem mais memória e processamento, mas o número de parâmetros sozinho não determina qualidade, velocidade ou fluência em português. Arquitetura, treinamento e quantização também importam.
Afinal, qual IA local escolher em 2026?
Para a maioria das pessoas que quer conversar em português do Brasil no PC, o melhor primeiro teste é combinar LM Studio ou Ollama com Qwen 3.5 9B, desde que o computador tenha memória suficiente. Em equipamentos básicos, comece pelo Qwen 3.5 4B. Para perguntas com imagens, compare o Gemma 4 12B; para problemas lógicos, vale incluir DeepSeek-R1 8B na comparação.
O resultado mais útil não é eleger um vencedor por nome. É encontrar a versão que responda de maneira natural em português, respeite suas instruções e caiba na memória disponível. Esse teste leva poucos minutos depois do primeiro download e revela mais sobre o uso cotidiano do que uma lista genérica de promessas.
Como esta seleção foi feita
Matéria apurada em 9 de outubro de 2026 a partir dos catálogos oficiais de modelos, páginas dos desenvolvedores e documentação dos aplicativos. Os tamanhos informados são os arquivos exibidos no Ollama nessa data; as faixas de RAM são orientações editoriais aproximadas, não medições em bancada. Não realizamos testes próprios de desempenho, fluência ou velocidade para construir este comparativo. As indicações por tarefa são baseadas nas capacidades declaradas e na adequação ao hardware. Resultados reais podem variar conforme versão, configuração e pergunta.
Fontes consultadas: Qwen 3.5 no Ollama; Qwen 3.6 no Ollama; Gemma 4; Ministral 3; DeepSeek-R1; gpt-oss; LM Studio — operação offline; requisitos do LM Studio; aplicativo Ollama; Jan; GPT4All; Open WebUI.
Comentários