 scale(1.0)%22%3E%3Cg transform=%22translate(0 0) scale(1.82)%22%3E%3Cdefs%3E%3CclipPath id=%22od-spectrum-1-clip%22 clipPathUnits=%22userSpaceOnUse%22%3E%3Cpath d=%22M83.54307596272014 16.073126206702106C66.79435401935054 -2.8024773671848067 38.25660907163116 -5.403803611249657 18.371112862359798 10.132448753007864C-1.5143833469115506 25.66870111726539 -5.894232963537952 53.98807085362926 8.368801953672723 74.80570597304838L23.482407872274567 62.99766290415789C15.698370900671726 50.550677768246715 18.572204113468143 34.235006451666294 30.140638663250094 25.196754816737943C41.70907321303204 16.158503181809593 58.235342541310885 17.31715323029148 68.42947004411829 27.88116927559259L83.54307596272014 16.073126206702106Z%22/%3E%3Cpath d=%22M81.57193800159959 25.194294026951617C95.83497291881025 46.01192914637073 91.45512330218386 74.33129888273459 71.56962709291251 89.86755124699212C51.684130883641146 105.40380361124966 23.146385935921764 102.80247736718479 6.397663992552161 83.92687379329787L21.511269911154002 72.1188307244074C31.70539741396142 82.6828467697085 48.231666742240265 83.8414968181904 59.800101292022205 74.80324518326205C71.36853584180416 65.76499354833369 74.24236905460057 49.44932223175327 66.45833208299773 37.0023370958421L81.57193800159959 25.194294026951617Z%22/%3E%3C/clipPath%3E%3CradialGradient id=%22od-spectrum-1-0%22 gradientUnits=%22userSpaceOnUse%22 cx=%220%22 cy=%220%22 r=%221%22 gradientTransform=%22translate(66 46) scale(61 110)%22%3E%3Cstop offset=%220%22 stop-color=%22%23F008E9%22 stop-opacity=%221%22/%3E%3Cstop offset=%22.15%22 stop-color=%22%23F008E9%22 stop-opacity=%220.95%22/%3E%3Cstop offset=%22.30%22 stop-color=%22%23F008E9%22 stop-opacity=%220.8%22/%3E%3Cstop offset=%22.45%22 stop-color=%22%23F008E9%22 stop-opacity=%220.57%22/%3E%3Cstop offset=%22.60%22 stop-color=%22%23F008E9%22 stop-opacity=%220.32%22/%3E%3Cstop offset=%22.75%22 stop-color=%22%23F008E9%22 stop-opacity=%220.13%22/%3E%3Cstop offset=%22.90%22 stop-color=%22%23F008E9%22 stop-opacity=%220.025%22/%3E%3Cstop offset=%221%22 stop-color=%22%23F008E9%22 stop-opacity=%220%22/%3E%3C/radialGradient%3E%3CradialGradient id=%22od-spectrum-1-1%22 gradientUnits=%22userSpaceOnUse%22 cx=%220%22 cy=%220%22 r=%221%22 gradientTransform=%22translate(55 2) scale(41 50)%22%3E%3Cstop offset=%220%22 stop-color=%22%23F008E9%22 stop-opacity=%221%22/%3E%3Cstop offset=%22.15%22 stop-color=%22%23F008E9%22 stop-opacity=%220.95%22/%3E%3Cstop offset=%22.30%22 stop-color=%22%23F008E9%22 stop-opacity=%220.8%22/%3E%3Cstop offset=%22.45%22 stop-color=%22%23F008E9%22 stop-opacity=%220.57%22/%3E%3Cstop offset=%22.60%22 stop-color=%22%23F008E9%22 stop-opacity=%220.32%22/%3E%3Cstop offset=%22.75%22 stop-color=%22%23F008E9%22 stop-opacity=%220.13%22/%3E%3Cstop offset=%22.90%22 stop-color=%22%23F008E9%22 stop-opacity=%220.025%22/%3E%3Cstop offset=%221%22 stop-color=%22%23F008E9%22 stop-opacity=%220%22/%3E%3C/radialGradient%3E%3CradialGradient id=%22od-spectrum-1-2%22 gradientUnits=%22userSpaceOnUse%22 cx=%220%22 cy=%220%22 r=%221%22 gradientTransform=%22translate(77 16) scale(30 42)%22%3E%3Cstop offset=%220%22 stop-color=%22%23FFD3A1%22 stop-opacity=%221%22/%3E%3Cstop offset=%22.15%22 stop-color=%22%23FFD3A1%22 stop-opacity=%220.95%22/%3E%3Cstop offset=%22.30%22 stop-color=%22%23FFD3A1%22 stop-opacity=%220.8%22/%3E%3Cstop offset=%22.45%22 stop-color=%22%23FFD3A1%22 stop-opacity=%220.57%22/%3E%3Cstop offset=%22.60%22 stop-color=%22%23FFD3A1%22 stop-opacity=%220.32%22/%3E%3Cstop offset=%22.75%22 stop-color=%22%23FFD3A1%22 stop-opacity=%220.13%22/%3E%3Cstop offset=%22.90%22 stop-color=%22%23FFD3A1%22 stop-opacity=%220.025%22/%3E%3Cstop offset=%221%22 stop-color=%22%23FFD3A1%22 stop-opacity=%220%22/%3E%3C/radialGradient%3E%3CradialGradient id=%22od-spectrum-1-3%22 gradientUnits=%22userSpaceOnUse%22 cx=%220%22 cy=%220%22 r=%221%22 gradientTransform=%22translate(86 76) scale(39 43)%22%3E%3Cstop offset=%220%22 stop-color=%22%23FFBC88%22 stop-opacity=%221%22/%3E%3Cstop offset=%22.15%22 stop-color=%22%23FFBC88%22 stop-opacity=%220.95%22/%3E%3Cstop offset=%22.30%22 stop-color=%22%23FFBC88%22 stop-opacity=%220.8%22/%3E%3Cstop offset=%22.45%22 stop-color=%22%23FFBC88%22 stop-opacity=%220.57%22/%3E%3Cstop offset=%22.60%22 stop-color=%22%23FFBC88%22 stop-opacity=%220.32%22/%3E%3Cstop offset=%22.75%22 stop-color=%22%23FFBC88%22 stop-opacity=%220.13%22/%3E%3Cstop offset=%22.90%22 stop-color=%22%23FFBC88%22 stop-opacity=%220.025%22/%3E%3Cstop offset=%221%22 stop-color=%22%23FFBC88%22 stop-opacity=%220%22/%3E%3C/radialGradient%3E%3CradialGradient id=%22od-spectrum-1-4%22 gradientUnits=%22userSpaceOnUse%22 cx=%220%22 cy=%220%22 r=%221%22 gradientTransform=%22translate(4 40) scale(28 35)%22%3E%3Cstop offset=%220%22 stop-color=%22%2342E5F5%22 stop-opacity=%221%22/%3E%3Cstop offset=%22.15%22 stop-color=%22%2342E5F5%22 stop-opacity=%220.95%22/%3E%3Cstop offset=%22.30%22 stop-color=%22%2342E5F5%22 stop-opacity=%220.8%22/%3E%3Cstop offset=%22.45%22 stop-color=%22%2342E5F5%22 stop-opacity=%220.57%22/%3E%3Cstop offset=%22.60%22 stop-color=%22%2342E5F5%22 stop-opacity=%220.32%22/%3E%3Cstop offset=%22.75%22 stop-color=%22%2342E5F5%22 stop-opacity=%220.13%22/%3E%3Cstop offset=%22.90%22 stop-color=%22%2342E5F5%22 stop-opacity=%220.025%22/%3E%3Cstop offset=%221%22 stop-color=%22%2342E5F5%22 stop-opacity=%220%22/%3E%3C/radialGradient%3E%3CradialGradient id=%22od-spectrum-1-5%22 gradientUnits=%22userSpaceOnUse%22 cx=%220%22 cy=%220%22 r=%221%22 gradientTransform=%22translate(5 44) scale(25 27)%22%3E%3Cstop offset=%220%22 stop-color=%22%23A4F6FC%22 stop-opacity=%220.45%22/%3E%3Cstop offset=%22.15%22 stop-color=%22%23A4F6FC%22 stop-opacity=%220.4275%22/%3E%3Cstop offset=%22.30%22 stop-color=%22%23A4F6FC%22 stop-opacity=%220.36000000000000004%22/%3E%3Cstop offset=%22.45%22 stop-color=%22%23A4F6FC%22 stop-opacity=%220.2565%22/%3E%3Cstop offset=%22.60%22 stop-color=%22%23A4F6FC%22 stop-opacity=%220.14400000000000002%22/%3E%3Cstop offset=%22.75%22 stop-color=%22%23A4F6FC%22 stop-opacity=%220.0585%22/%3E%3Cstop offset=%22.90%22 stop-color=%22%23A4F6FC%22 stop-opacity=%220.011250000000000001%22/%3E%3Cstop offset=%221%22 stop-color=%22%23A4F6FC%22 stop-opacity=%220%22/%3E%3C/radialGradient%3E%3CradialGradient id=%22od-spectrum-1-6%22 gradientUnits=%22userSpaceOnUse%22 cx=%220%22 cy=%220%22 r=%221%22 gradientTransform=%22translate(48 81) scale(33 40)%22%3E%3Cstop offset=%220%22 stop-color=%22%23F008E9%22 stop-opacity=%220.65%22/%3E%3Cstop offset=%22.15%22 stop-color=%22%23F008E9%22 stop-opacity=%220.6174999999999999%22/%3E%3Cstop offset=%22.30%22 stop-color=%22%23F008E9%22 stop-opacity=%220.52%22/%3E%3Cstop offset=%22.45%22 stop-color=%22%23F008E9%22 stop-opacity=%220.3705%22/%3E%3Cstop offset=%22.60%22 stop-color=%22%23F008E9%22 stop-opacity=%220.20800000000000002%22/%3E%3Cstop offset=%22.75%22 stop-color=%22%23F008E9%22 stop-opacity=%220.0845%22/%3E%3Cstop offset=%22.90%22 stop-color=%22%23F008E9%22 stop-opacity=%220.01625%22/%3E%3Cstop offset=%221%22 stop-color=%22%23F008E9%22 stop-opacity=%220%22/%3E%3C/radialGradient%3E%3C/defs%3E%3Cg clip-path=%22url(%23od-spectrum-1-clip)%22%3E%3Crect x=%22-2%22 y=%22-2%22 width=%22104%22 height=%22104%22 rx=%220%22 fill=%22%237900FF%22/%3E%3Crect x=%22-2%22 y=%22-2%22 width=%22104%22 height=%22104%22 rx=%220%22 fill=%22url(%23od-spectrum-1-0)%22/%3E%3Crect x=%22-2%22 y=%22-2%22 width=%22104%22 height=%22104%22 rx=%220%22 fill=%22url(%23od-spectrum-1-1)%22/%3E%3Crect x=%22-2%22 y=%22-2%22 width=%22104%22 height=%22104%22 rx=%220%22 fill=%22url(%23od-spectrum-1-2)%22/%3E%3Crect x=%22-2%22 y=%22-2%22 width=%22104%22 height=%22104%22 rx=%220%22 fill=%22url(%23od-spectrum-1-3)%22/%3E%3Crect x=%22-2%22 y=%22-2%22 width=%22104%22 height=%22104%22 rx=%220%22 fill=%22url(%23od-spectrum-1-4)%22/%3E%3Crect x=%22-2%22 y=%22-2%22 width=%22104%22 height=%22104%22 rx=%220%22 fill=%22url(%23od-spectrum-1-5)%22/%3E%3Crect x=%22-2%22 y=%22-2%22 width=%22104%22 height=%22104%22 rx=%220%22 fill=%22url(%23od-spectrum-1-6)%22/%3E%3C/g%3E%3C/g%3E%3Cg fill=%22%23FFFFFF%22 fill-rule=%22evenodd%22 transform=%22translate(187.69215 41.00000) scale(0.5651341) translate(-0.379694 -0.457663)%22%3E%3Cpath d=%22M 742.365 0.955 C 728.306 4.297, 725.001 24.441, 737.300 31.818 C 749.085 38.887, 764 30.943, 764 17.597 C 764 6.454, 753.431 -1.675, 742.365 0.955 M 603 25.918 C 603 38.523, 602.741 49.511, 602.425 50.335 C 601.964 51.536, 600.585 51.040, 595.468 47.832 C 583.144 40.105, 566.066 36.205, 549.581 37.353 C 536.978 38.231, 529.063 40.315, 518 45.668 C 510.023 49.529, 507.103 51.660, 499.786 58.962 C 492.669 66.064, 490.337 69.201, 487.062 76.079 C 481.613 87.520, 479.975 94.556, 479.860 107 C 479.603 134.954, 493.097 156.957, 518.273 169.637 C 528.623 174.850, 540.238 177.313, 554.500 177.321 C 571.672 177.330, 583.787 173.917, 596.127 165.596 L 601.500 161.972 601.796 168.486 L 602.091 175 618.546 175 L 635 175 635 89 L 635 3 619 3 L 603 3 603 25.918 M 60.107 38.094 C 44.032 40.562, 31.906 46.852, 20 58.899 C 10.798 68.210, 5.589 77.105, 2.232 89.240 C -0.471 99.010, -0.170 118.315, 2.836 128 C 9.904 150.777, 28.698 168.805, 51.784 174.954 C 60.134 177.179, 72.202 177.996, 81.486 176.966 C 99.884 174.925, 113.356 168.669, 125.628 156.468 C 138.837 143.335, 145.195 127.577, 145.184 108 C 145.167 78.767, 130.539 55.662, 104.687 44.035 C 92.107 38.377, 73.990 35.962, 60.107 38.094 M 312.330 38.488 C 288.588 43.950, 269.644 60.920, 261.294 84.205 C 257.478 94.846, 256.859 113.284, 259.941 124.516 C 263.456 137.330, 268.204 145.302, 278.448 155.593 C 298.769 176.006, 323.821 182.304, 349.477 173.450 C 372.578 165.478, 391.587 140.454, 394.570 114.087 C 395.118 109.243, 394.977 108.004, 393.879 108.021 C 393.121 108.032, 387.100 108.693, 380.500 109.490 C 373.900 110.286, 368.015 110.952, 367.422 110.969 C 366.829 110.986, 365.819 113.272, 365.178 116.048 C 362.190 128.995, 354.708 139.049, 344.218 144.213 C 338.088 147.231, 336.764 147.500, 328.021 147.500 C 319.735 147.500, 317.742 147.145, 312.658 144.763 L 306.815 142.026 309.658 139.691 C 311.221 138.406, 324.650 127.924, 339.500 116.396 C 380.981 84.196, 388.275 78.554, 389.350 77.834 C 390.924 76.781, 382.218 64.207, 374.924 57 C 362.207 44.435, 347.275 38.073, 329 37.435 C 322.227 37.199, 316.310 37.573, 312.330 38.488 M 943.500 38.408 C 917.805 44.323, 897.599 64.183, 891.324 89.689 C 889.085 98.788, 889.130 115.414, 891.417 123.920 C 896.714 143.625, 911.194 161.145, 929.500 169.999 C 940.604 175.370, 948.650 177.292, 960 177.287 C 981.823 177.276, 1000.418 167.833, 1013.956 149.889 C 1022.370 138.736, 1026.241 128.867, 1026.801 117.141 L 1027.248 107.782 1023.374 108.362 C 1021.243 108.680, 1015.107 109.461, 1009.738 110.096 C 1000.390 111.201, 999.952 111.362, 999.427 113.875 C 996.597 127.431, 988.308 138.755, 977.225 144.209 C 971.001 147.271, 969.837 147.499, 960.518 147.487 C 951.719 147.475, 949.787 147.141, 944.641 144.742 L 938.782 142.011 966.145 120.755 C 990.298 101.994, 1016.512 81.704, 1020.946 78.340 C 1022.269 77.336, 1021.828 76.231, 1017.671 70.148 C 1008.057 56.077, 993.928 45.338, 978.500 40.375 C 968.602 37.192, 952.674 36.296, 943.500 38.408 M 134.353 42.250 C 134.667 43.487, 145.693 73.750, 158.855 109.500 L 182.786 174.500 201.905 174.772 C 220.952 175.042, 221.027 175.035, 221.997 172.772 C 225.867 163.749, 272 41.976, 272 40.786 C 272 40.353, 264.665 40, 255.699 40 L 239.399 40 237.200 46.250 C 235.991 49.688, 227.695 72.389, 218.764 96.698 L 202.528 140.897 193.724 114.698 C 182.662 81.782, 170.157 45.203, 168.957 42.250 C 168.059 40.040, 167.740 40, 150.913 40 L 133.783 40 134.353 42.250 M 434.105 41.583 C 421.700 44.918, 410.970 54.152, 404.449 67.102 C 398.445 79.025, 398.055 82.416, 397.554 127.143 C 397.305 149.339, 397.361 169.188, 397.678 171.250 L 398.256 175 413.628 175 L 429 175 429.075 151.250 C 429.117 138.188, 429.484 117.825, 429.893 106 C 430.724 81.913, 431.478 79.049, 438.510 73.253 C 444.094 68.650, 448.059 67.810, 466.750 67.271 L 484 66.773 484 53.387 L 484 40 461.750 40.066 C 445.632 40.113, 438.013 40.531, 434.105 41.583 M 680.348 41.420 C 662.969 45.635, 649.145 60.553, 644.549 80.053 C 643.311 85.306, 643.027 94.697, 643.015 130.750 L 643 175 658.500 175 L 674 175 674.096 160.750 C 674.149 152.912, 674.490 132.550, 674.855 115.500 C 675.509 84.911, 675.550 84.441, 678.009 80.039 C 680.779 75.079, 685.458 71.464, 690.901 70.081 C 692.880 69.578, 700.237 68.859, 707.250 68.483 L 720 67.799 720 53.899 L 720 40 702.750 40.085 C 692.675 40.135, 683.357 40.690, 680.348 41.420 M 731 107.500 L 731 175 747 175 L 763 175 763 107.500 L 763 40 747 40 L 731 40 731 107.500 M 767.002 40.726 C 767.004 41.501, 771.329 53.694, 787.493 98.500 C 792.255 111.700, 798.802 129.925, 802.041 139 C 805.281 148.075, 809.474 159.775, 811.359 165 L 814.788 174.500 834.017 174.500 L 853.247 174.500 862.135 151 C 892.010 72.006, 903 42.401, 903 40.914 C 903 40.400, 896.077 40, 887.194 40 L 871.389 40 860.241 70.750 C 854.109 87.662, 846.183 109.600, 842.627 119.500 C 839.071 129.400, 835.833 138.337, 835.432 139.360 C 834.932 140.634, 829.453 125.354, 818.043 90.860 L 801.385 40.500 784.193 40.226 C 774.737 40.076, 767.001 40.301, 767.002 40.726 M 61.746 67.031 C 55.710 68.542, 48.242 72.758, 43.885 77.115 C 35.353 85.647, 30.768 101.246, 32.919 114.418 C 36.659 137.316, 53.115 150.299, 76.385 148.709 C 98.060 147.229, 112.882 130.519, 112.976 107.460 C 113.046 89.974, 103.452 74.414, 89.202 68.902 C 82.798 66.426, 68.150 65.427, 61.746 67.031 M 314.286 67.451 C 304.042 70.652, 295.740 77.992, 291.177 87.880 C 288.044 94.672, 287.012 109.669, 289.190 116.766 L 290.500 121.031 299.148 114.266 C 303.904 110.545, 317.280 100.300, 328.871 91.500 C 340.462 82.700, 349.955 75.275, 349.966 75 C 350.011 73.882, 342.527 69.530, 337.679 67.855 C 331.549 65.737, 320.388 65.544, 314.286 67.451 M 543 67.603 C 527.177 71.836, 516.702 83.808, 513.883 100.878 C 511.041 118.086, 518.907 135.733, 532.786 143.287 C 555.907 155.871, 585.840 147.268, 596.413 125 C 599.281 118.961, 599.500 117.720, 599.500 107.500 C 599.500 97.275, 599.282 96.042, 596.410 90 C 592.465 81.702, 589.352 78.069, 581.965 73.136 C 572.030 66.501, 555.756 64.190, 543 67.603 M 945.624 67.637 C 931.972 71.829, 922.437 83.566, 919.699 99.549 C 918.639 105.739, 919.734 115.913, 921.872 119.735 C 922.343 120.576, 926.568 117.867, 935.131 111.235 C 947.247 101.849, 965.214 88.020, 976.591 79.322 L 982.055 75.144 978.558 72.477 C 970.885 66.624, 956.030 64.441, 945.624 67.637%22/%3E%3C/g%3E%3C/g%3E%3C/svg%3E)
 scale(1.0)%22%3E%3Cg transform=%22translate(0 0) scale(1.82)%22%3E%3Cdefs%3E%3CclipPath id=%22od-spectrum-2-clip%22 clipPathUnits=%22userSpaceOnUse%22%3E%3Cpath d=%22M83.54307596272014 16.073126206702106C66.79435401935054 -2.8024773671848067 38.25660907163116 -5.403803611249657 18.371112862359798 10.132448753007864C-1.5143833469115506 25.66870111726539 -5.894232963537952 53.98807085362926 8.368801953672723 74.80570597304838L23.482407872274567 62.99766290415789C15.698370900671726 50.550677768246715 18.572204113468143 34.235006451666294 30.140638663250094 25.196754816737943C41.70907321303204 16.158503181809593 58.235342541310885 17.31715323029148 68.42947004411829 27.88116927559259L83.54307596272014 16.073126206702106Z%22/%3E%3Cpath d=%22M81.57193800159959 25.194294026951617C95.83497291881025 46.01192914637073 91.45512330218386 74.33129888273459 71.56962709291251 89.86755124699212C51.684130883641146 105.40380361124966 23.146385935921764 102.80247736718479 6.397663992552161 83.92687379329787L21.511269911154002 72.1188307244074C31.70539741396142 82.6828467697085 48.231666742240265 83.8414968181904 59.800101292022205 74.80324518326205C71.36853584180416 65.76499354833369 74.24236905460057 49.44932223175327 66.45833208299773 37.0023370958421L81.57193800159959 25.194294026951617Z%22/%3E%3C/clipPath%3E%3CradialGradient id=%22od-spectrum-2-0%22 gradientUnits=%22userSpaceOnUse%22 cx=%220%22 cy=%220%22 r=%221%22 gradientTransform=%22translate(66 46) scale(61 110)%22%3E%3Cstop offset=%220%22 stop-color=%22%23F008E9%22 stop-opacity=%221%22/%3E%3Cstop offset=%22.15%22 stop-color=%22%23F008E9%22 stop-opacity=%220.95%22/%3E%3Cstop offset=%22.30%22 stop-color=%22%23F008E9%22 stop-opacity=%220.8%22/%3E%3Cstop offset=%22.45%22 stop-color=%22%23F008E9%22 stop-opacity=%220.57%22/%3E%3Cstop offset=%22.60%22 stop-color=%22%23F008E9%22 stop-opacity=%220.32%22/%3E%3Cstop offset=%22.75%22 stop-color=%22%23F008E9%22 stop-opacity=%220.13%22/%3E%3Cstop offset=%22.90%22 stop-color=%22%23F008E9%22 stop-opacity=%220.025%22/%3E%3Cstop offset=%221%22 stop-color=%22%23F008E9%22 stop-opacity=%220%22/%3E%3C/radialGradient%3E%3CradialGradient id=%22od-spectrum-2-1%22 gradientUnits=%22userSpaceOnUse%22 cx=%220%22 cy=%220%22 r=%221%22 gradientTransform=%22translate(55 2) scale(41 50)%22%3E%3Cstop offset=%220%22 stop-color=%22%23F008E9%22 stop-opacity=%221%22/%3E%3Cstop offset=%22.15%22 stop-color=%22%23F008E9%22 stop-opacity=%220.95%22/%3E%3Cstop offset=%22.30%22 stop-color=%22%23F008E9%22 stop-opacity=%220.8%22/%3E%3Cstop offset=%22.45%22 stop-color=%22%23F008E9%22 stop-opacity=%220.57%22/%3E%3Cstop offset=%22.60%22 stop-color=%22%23F008E9%22 stop-opacity=%220.32%22/%3E%3Cstop offset=%22.75%22 stop-color=%22%23F008E9%22 stop-opacity=%220.13%22/%3E%3Cstop offset=%22.90%22 stop-color=%22%23F008E9%22 stop-opacity=%220.025%22/%3E%3Cstop offset=%221%22 stop-color=%22%23F008E9%22 stop-opacity=%220%22/%3E%3C/radialGradient%3E%3CradialGradient id=%22od-spectrum-2-2%22 gradientUnits=%22userSpaceOnUse%22 cx=%220%22 cy=%220%22 r=%221%22 gradientTransform=%22translate(77 16) scale(30 42)%22%3E%3Cstop offset=%220%22 stop-color=%22%23FFD3A1%22 stop-opacity=%221%22/%3E%3Cstop offset=%22.15%22 stop-color=%22%23FFD3A1%22 stop-opacity=%220.95%22/%3E%3Cstop offset=%22.30%22 stop-color=%22%23FFD3A1%22 stop-opacity=%220.8%22/%3E%3Cstop offset=%22.45%22 stop-color=%22%23FFD3A1%22 stop-opacity=%220.57%22/%3E%3Cstop offset=%22.60%22 stop-color=%22%23FFD3A1%22 stop-opacity=%220.32%22/%3E%3Cstop offset=%22.75%22 stop-color=%22%23FFD3A1%22 stop-opacity=%220.13%22/%3E%3Cstop offset=%22.90%22 stop-color=%22%23FFD3A1%22 stop-opacity=%220.025%22/%3E%3Cstop offset=%221%22 stop-color=%22%23FFD3A1%22 stop-opacity=%220%22/%3E%3C/radialGradient%3E%3CradialGradient id=%22od-spectrum-2-3%22 gradientUnits=%22userSpaceOnUse%22 cx=%220%22 cy=%220%22 r=%221%22 gradientTransform=%22translate(86 76) scale(39 43)%22%3E%3Cstop offset=%220%22 stop-color=%22%23FFBC88%22 stop-opacity=%221%22/%3E%3Cstop offset=%22.15%22 stop-color=%22%23FFBC88%22 stop-opacity=%220.95%22/%3E%3Cstop offset=%22.30%22 stop-color=%22%23FFBC88%22 stop-opacity=%220.8%22/%3E%3Cstop offset=%22.45%22 stop-color=%22%23FFBC88%22 stop-opacity=%220.57%22/%3E%3Cstop offset=%22.60%22 stop-color=%22%23FFBC88%22 stop-opacity=%220.32%22/%3E%3Cstop offset=%22.75%22 stop-color=%22%23FFBC88%22 stop-opacity=%220.13%22/%3E%3Cstop offset=%22.90%22 stop-color=%22%23FFBC88%22 stop-opacity=%220.025%22/%3E%3Cstop offset=%221%22 stop-color=%22%23FFBC88%22 stop-opacity=%220%22/%3E%3C/radialGradient%3E%3CradialGradient id=%22od-spectrum-2-4%22 gradientUnits=%22userSpaceOnUse%22 cx=%220%22 cy=%220%22 r=%221%22 gradientTransform=%22translate(4 40) scale(28 35)%22%3E%3Cstop offset=%220%22 stop-color=%22%2342E5F5%22 stop-opacity=%221%22/%3E%3Cstop offset=%22.15%22 stop-color=%22%2342E5F5%22 stop-opacity=%220.95%22/%3E%3Cstop offset=%22.30%22 stop-color=%22%2342E5F5%22 stop-opacity=%220.8%22/%3E%3Cstop offset=%22.45%22 stop-color=%22%2342E5F5%22 stop-opacity=%220.57%22/%3E%3Cstop offset=%22.60%22 stop-color=%22%2342E5F5%22 stop-opacity=%220.32%22/%3E%3Cstop offset=%22.75%22 stop-color=%22%2342E5F5%22 stop-opacity=%220.13%22/%3E%3Cstop offset=%22.90%22 stop-color=%22%2342E5F5%22 stop-opacity=%220.025%22/%3E%3Cstop offset=%221%22 stop-color=%22%2342E5F5%22 stop-opacity=%220%22/%3E%3C/radialGradient%3E%3CradialGradient id=%22od-spectrum-2-5%22 gradientUnits=%22userSpaceOnUse%22 cx=%220%22 cy=%220%22 r=%221%22 gradientTransform=%22translate(5 44) scale(25 27)%22%3E%3Cstop offset=%220%22 stop-color=%22%23A4F6FC%22 stop-opacity=%220.45%22/%3E%3Cstop offset=%22.15%22 stop-color=%22%23A4F6FC%22 stop-opacity=%220.4275%22/%3E%3Cstop offset=%22.30%22 stop-color=%22%23A4F6FC%22 stop-opacity=%220.36000000000000004%22/%3E%3Cstop offset=%22.45%22 stop-color=%22%23A4F6FC%22 stop-opacity=%220.2565%22/%3E%3Cstop offset=%22.60%22 stop-color=%22%23A4F6FC%22 stop-opacity=%220.14400000000000002%22/%3E%3Cstop offset=%22.75%22 stop-color=%22%23A4F6FC%22 stop-opacity=%220.0585%22/%3E%3Cstop offset=%22.90%22 stop-color=%22%23A4F6FC%22 stop-opacity=%220.011250000000000001%22/%3E%3Cstop offset=%221%22 stop-color=%22%23A4F6FC%22 stop-opacity=%220%22/%3E%3C/radialGradient%3E%3CradialGradient id=%22od-spectrum-2-6%22 gradientUnits=%22userSpaceOnUse%22 cx=%220%22 cy=%220%22 r=%221%22 gradientTransform=%22translate(48 81) scale(33 40)%22%3E%3Cstop offset=%220%22 stop-color=%22%23F008E9%22 stop-opacity=%220.65%22/%3E%3Cstop offset=%22.15%22 stop-color=%22%23F008E9%22 stop-opacity=%220.6174999999999999%22/%3E%3Cstop offset=%22.30%22 stop-color=%22%23F008E9%22 stop-opacity=%220.52%22/%3E%3Cstop offset=%22.45%22 stop-color=%22%23F008E9%22 stop-opacity=%220.3705%22/%3E%3Cstop offset=%22.60%22 stop-color=%22%23F008E9%22 stop-opacity=%220.20800000000000002%22/%3E%3Cstop offset=%22.75%22 stop-color=%22%23F008E9%22 stop-opacity=%220.0845%22/%3E%3Cstop offset=%22.90%22 stop-color=%22%23F008E9%22 stop-opacity=%220.01625%22/%3E%3Cstop offset=%221%22 stop-color=%22%23F008E9%22 stop-opacity=%220%22/%3E%3C/radialGradient%3E%3C/defs%3E%3Cg clip-path=%22url(%23od-spectrum-2-clip)%22%3E%3Crect x=%22-2%22 y=%22-2%22 width=%22104%22 height=%22104%22 rx=%220%22 fill=%22%237900FF%22/%3E%3Crect x=%22-2%22 y=%22-2%22 width=%22104%22 height=%22104%22 rx=%220%22 fill=%22url(%23od-spectrum-2-0)%22/%3E%3Crect x=%22-2%22 y=%22-2%22 width=%22104%22 height=%22104%22 rx=%220%22 fill=%22url(%23od-spectrum-2-1)%22/%3E%3Crect x=%22-2%22 y=%22-2%22 width=%22104%22 height=%22104%22 rx=%220%22 fill=%22url(%23od-spectrum-2-2)%22/%3E%3Crect x=%22-2%22 y=%22-2%22 width=%22104%22 height=%22104%22 rx=%220%22 fill=%22url(%23od-spectrum-2-3)%22/%3E%3Crect x=%22-2%22 y=%22-2%22 width=%22104%22 height=%22104%22 rx=%220%22 fill=%22url(%23od-spectrum-2-4)%22/%3E%3Crect x=%22-2%22 y=%22-2%22 width=%22104%22 height=%22104%22 rx=%220%22 fill=%22url(%23od-spectrum-2-5)%22/%3E%3Crect x=%22-2%22 y=%22-2%22 width=%22104%22 height=%22104%22 rx=%220%22 fill=%22url(%23od-spectrum-2-6)%22/%3E%3C/g%3E%3C/g%3E%3Cg fill=%22%23111015%22 fill-rule=%22evenodd%22 transform=%22translate(187.69215 41.00000) scale(0.5651341) translate(-0.379694 -0.457663)%22%3E%3Cpath d=%22M 742.365 0.955 C 728.306 4.297, 725.001 24.441, 737.300 31.818 C 749.085 38.887, 764 30.943, 764 17.597 C 764 6.454, 753.431 -1.675, 742.365 0.955 M 603 25.918 C 603 38.523, 602.741 49.511, 602.425 50.335 C 601.964 51.536, 600.585 51.040, 595.468 47.832 C 583.144 40.105, 566.066 36.205, 549.581 37.353 C 536.978 38.231, 529.063 40.315, 518 45.668 C 510.023 49.529, 507.103 51.660, 499.786 58.962 C 492.669 66.064, 490.337 69.201, 487.062 76.079 C 481.613 87.520, 479.975 94.556, 479.860 107 C 479.603 134.954, 493.097 156.957, 518.273 169.637 C 528.623 174.850, 540.238 177.313, 554.500 177.321 C 571.672 177.330, 583.787 173.917, 596.127 165.596 L 601.500 161.972 601.796 168.486 L 602.091 175 618.546 175 L 635 175 635 89 L 635 3 619 3 L 603 3 603 25.918 M 60.107 38.094 C 44.032 40.562, 31.906 46.852, 20 58.899 C 10.798 68.210, 5.589 77.105, 2.232 89.240 C -0.471 99.010, -0.170 118.315, 2.836 128 C 9.904 150.777, 28.698 168.805, 51.784 174.954 C 60.134 177.179, 72.202 177.996, 81.486 176.966 C 99.884 174.925, 113.356 168.669, 125.628 156.468 C 138.837 143.335, 145.195 127.577, 145.184 108 C 145.167 78.767, 130.539 55.662, 104.687 44.035 C 92.107 38.377, 73.990 35.962, 60.107 38.094 M 312.330 38.488 C 288.588 43.950, 269.644 60.920, 261.294 84.205 C 257.478 94.846, 256.859 113.284, 259.941 124.516 C 263.456 137.330, 268.204 145.302, 278.448 155.593 C 298.769 176.006, 323.821 182.304, 349.477 173.450 C 372.578 165.478, 391.587 140.454, 394.570 114.087 C 395.118 109.243, 394.977 108.004, 393.879 108.021 C 393.121 108.032, 387.100 108.693, 380.500 109.490 C 373.900 110.286, 368.015 110.952, 367.422 110.969 C 366.829 110.986, 365.819 113.272, 365.178 116.048 C 362.190 128.995, 354.708 139.049, 344.218 144.213 C 338.088 147.231, 336.764 147.500, 328.021 147.500 C 319.735 147.500, 317.742 147.145, 312.658 144.763 L 306.815 142.026 309.658 139.691 C 311.221 138.406, 324.650 127.924, 339.500 116.396 C 380.981 84.196, 388.275 78.554, 389.350 77.834 C 390.924 76.781, 382.218 64.207, 374.924 57 C 362.207 44.435, 347.275 38.073, 329 37.435 C 322.227 37.199, 316.310 37.573, 312.330 38.488 M 943.500 38.408 C 917.805 44.323, 897.599 64.183, 891.324 89.689 C 889.085 98.788, 889.130 115.414, 891.417 123.920 C 896.714 143.625, 911.194 161.145, 929.500 169.999 C 940.604 175.370, 948.650 177.292, 960 177.287 C 981.823 177.276, 1000.418 167.833, 1013.956 149.889 C 1022.370 138.736, 1026.241 128.867, 1026.801 117.141 L 1027.248 107.782 1023.374 108.362 C 1021.243 108.680, 1015.107 109.461, 1009.738 110.096 C 1000.390 111.201, 999.952 111.362, 999.427 113.875 C 996.597 127.431, 988.308 138.755, 977.225 144.209 C 971.001 147.271, 969.837 147.499, 960.518 147.487 C 951.719 147.475, 949.787 147.141, 944.641 144.742 L 938.782 142.011 966.145 120.755 C 990.298 101.994, 1016.512 81.704, 1020.946 78.340 C 1022.269 77.336, 1021.828 76.231, 1017.671 70.148 C 1008.057 56.077, 993.928 45.338, 978.500 40.375 C 968.602 37.192, 952.674 36.296, 943.500 38.408 M 134.353 42.250 C 134.667 43.487, 145.693 73.750, 158.855 109.500 L 182.786 174.500 201.905 174.772 C 220.952 175.042, 221.027 175.035, 221.997 172.772 C 225.867 163.749, 272 41.976, 272 40.786 C 272 40.353, 264.665 40, 255.699 40 L 239.399 40 237.200 46.250 C 235.991 49.688, 227.695 72.389, 218.764 96.698 L 202.528 140.897 193.724 114.698 C 182.662 81.782, 170.157 45.203, 168.957 42.250 C 168.059 40.040, 167.740 40, 150.913 40 L 133.783 40 134.353 42.250 M 434.105 41.583 C 421.700 44.918, 410.970 54.152, 404.449 67.102 C 398.445 79.025, 398.055 82.416, 397.554 127.143 C 397.305 149.339, 397.361 169.188, 397.678 171.250 L 398.256 175 413.628 175 L 429 175 429.075 151.250 C 429.117 138.188, 429.484 117.825, 429.893 106 C 430.724 81.913, 431.478 79.049, 438.510 73.253 C 444.094 68.650, 448.059 67.810, 466.750 67.271 L 484 66.773 484 53.387 L 484 40 461.750 40.066 C 445.632 40.113, 438.013 40.531, 434.105 41.583 M 680.348 41.420 C 662.969 45.635, 649.145 60.553, 644.549 80.053 C 643.311 85.306, 643.027 94.697, 643.015 130.750 L 643 175 658.500 175 L 674 175 674.096 160.750 C 674.149 152.912, 674.490 132.550, 674.855 115.500 C 675.509 84.911, 675.550 84.441, 678.009 80.039 C 680.779 75.079, 685.458 71.464, 690.901 70.081 C 692.880 69.578, 700.237 68.859, 707.250 68.483 L 720 67.799 720 53.899 L 720 40 702.750 40.085 C 692.675 40.135, 683.357 40.690, 680.348 41.420 M 731 107.500 L 731 175 747 175 L 763 175 763 107.500 L 763 40 747 40 L 731 40 731 107.500 M 767.002 40.726 C 767.004 41.501, 771.329 53.694, 787.493 98.500 C 792.255 111.700, 798.802 129.925, 802.041 139 C 805.281 148.075, 809.474 159.775, 811.359 165 L 814.788 174.500 834.017 174.500 L 853.247 174.500 862.135 151 C 892.010 72.006, 903 42.401, 903 40.914 C 903 40.400, 896.077 40, 887.194 40 L 871.389 40 860.241 70.750 C 854.109 87.662, 846.183 109.600, 842.627 119.500 C 839.071 129.400, 835.833 138.337, 835.432 139.360 C 834.932 140.634, 829.453 125.354, 818.043 90.860 L 801.385 40.500 784.193 40.226 C 774.737 40.076, 767.001 40.301, 767.002 40.726 M 61.746 67.031 C 55.710 68.542, 48.242 72.758, 43.885 77.115 C 35.353 85.647, 30.768 101.246, 32.919 114.418 C 36.659 137.316, 53.115 150.299, 76.385 148.709 C 98.060 147.229, 112.882 130.519, 112.976 107.460 C 113.046 89.974, 103.452 74.414, 89.202 68.902 C 82.798 66.426, 68.150 65.427, 61.746 67.031 M 314.286 67.451 C 304.042 70.652, 295.740 77.992, 291.177 87.880 C 288.044 94.672, 287.012 109.669, 289.190 116.766 L 290.500 121.031 299.148 114.266 C 303.904 110.545, 317.280 100.300, 328.871 91.500 C 340.462 82.700, 349.955 75.275, 349.966 75 C 350.011 73.882, 342.527 69.530, 337.679 67.855 C 331.549 65.737, 320.388 65.544, 314.286 67.451 M 543 67.603 C 527.177 71.836, 516.702 83.808, 513.883 100.878 C 511.041 118.086, 518.907 135.733, 532.786 143.287 C 555.907 155.871, 585.840 147.268, 596.413 125 C 599.281 118.961, 599.500 117.720, 599.500 107.500 C 599.500 97.275, 599.282 96.042, 596.410 90 C 592.465 81.702, 589.352 78.069, 581.965 73.136 C 572.030 66.501, 555.756 64.190, 543 67.603 M 945.624 67.637 C 931.972 71.829, 922.437 83.566, 919.699 99.549 C 918.639 105.739, 919.734 115.913, 921.872 119.735 C 922.343 120.576, 926.568 117.867, 935.131 111.235 C 947.247 101.849, 965.214 88.020, 976.591 79.322 L 982.055 75.144 978.558 72.477 C 970.885 66.624, 956.030 64.441, 945.624 67.637%22/%3E%3C/g%3E%3C/g%3E%3C/svg%3E)

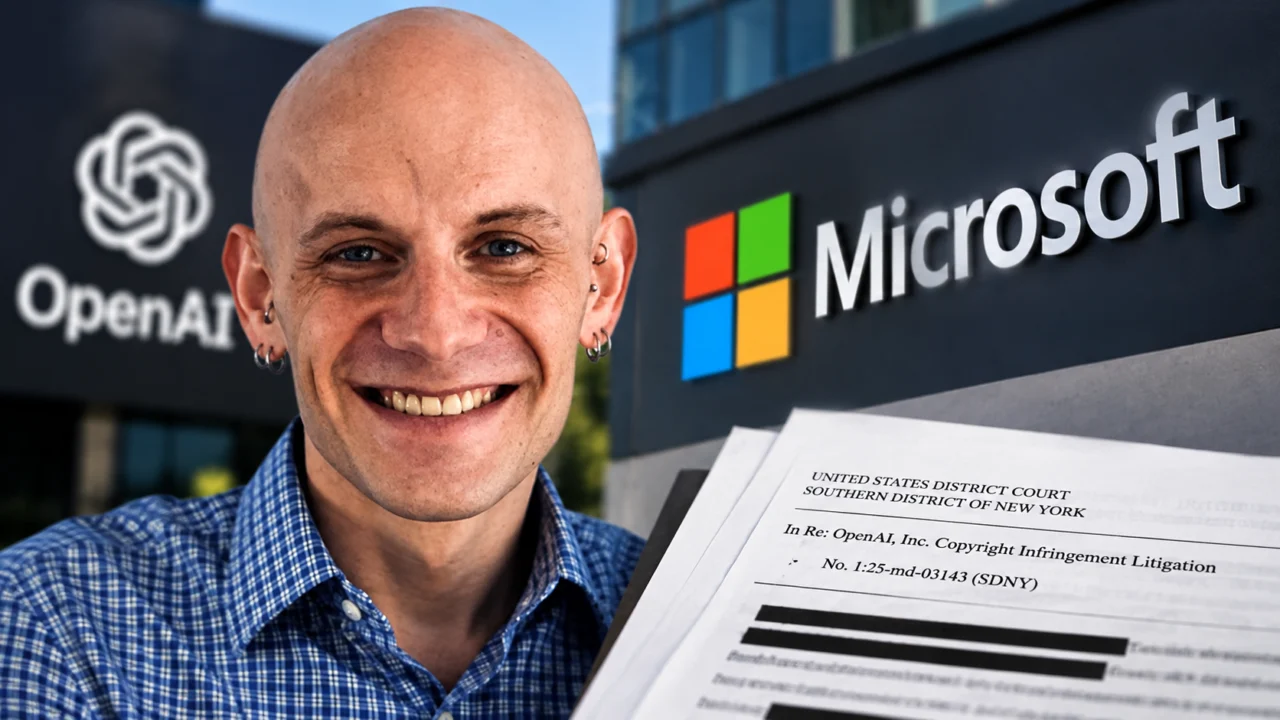
Um executivo da Microsoft descreveu internamente a coleta em massa de conteúdo para sistemas de inteligência artificial como o “maior roubo de trabalho da história da humanidade”. A declaração, que até agora não era pública, apareceu em trechos de documentos judiciais revelados nesta quinta-feira (17).
A frase é de Brent Hecht, diretor de Applied Science e Partner da Microsoft. Ela surge em meio ao processo que reúne acusações de veículos de imprensa contra Microsoft e OpenAI pelo uso de material protegido por direitos autorais no desenvolvimento de modelos de IA.
Os novos trechos vão além da declaração. Eles mostram discussões internas sobre o impacto econômico da inteligência artificial sobre os próprios produtores de conteúdo, bases contendo grandes quantidades de material jornalístico e métodos utilizados para reunir dados destinados aos modelos.
Há, porém, uma distinção importante: a declaração de Hecht não representa a posição oficial da Microsoft. A empresa afirma que se trata da opinião individual de um funcionário e mantém sua defesa de que o treinamento de modelos pode estar protegido pela doutrina de fair use nos Estados Unidos.
O que o executivo da Microsoft disse sobre IA?
Brent Hecht teria feito a declaração em um memorando interno de janeiro de 2023 ao discutir a utilização de grandes volumes de conteúdo produzido por terceiros.
Segundo trechos revelados no processo, Hecht classificou a prática como um roubo em escala sem precedentes e afirmou que poderia representar o “maior roubo de trabalho da história da humanidade”.
Hecht não é um executivo aleatório dentro da companhia. O próprio perfil da Microsoft Research o apresenta como Partner Director of Applied Science, com trabalho voltado a inteligência artificial, futuro do trabalho e formas sustentáveis de relacionamento entre sistemas de IA e produtores de dados. Brent Hecht é Partner Director of Applied Science da Microsoft e pesquisa IA e futuro do trabalho. Foto: Microsoft Research
O tema também conversa diretamente com uma discussão que ganhou força dentro da própria Microsoft. Recentemente, a empresa publicou uma espécie de “constituição” para seus futuros modelos de inteligência artificial, colocando controle humano e limites de atuação entre os princípios centrais.
Documentos citam milhões de páginas usadas em bases de treinamento
Os documentos apresentados pelos veículos de imprensa no processo detalham a escala do material que teria sido reunido para treinamento.
Segundo a petição, determinados conjuntos de dados intermediários da OpenAI continham mais de 91 mil cópias de obras publicadas por veículos envolvidos na disputa judicial, entre eles The New York Times, Daily News e Center for Investigative Reporting.
Outro conjunto derivado do Common Crawl teria incluído mais de 2 milhões de documentos do domínio do The New York Times.
Esses números aparecem na argumentação dos autores do processo. Eles não significam, por si só, que um tribunal tenha determinado que todas essas cópias foram ilegais.
Microsoft e OpenAI teriam trocado grandes bases de dados
Os documentos também descrevem uma relação de troca de dados entre Microsoft e OpenAI durante o desenvolvimento dos modelos.
De acordo com a petição, a OpenAI forneceu à Microsoft o conjunto completo utilizado no treinamento do GPT-3 para que a empresa avaliasse como incorporar os modelos aos seus próprios produtos.
A Microsoft, por sua vez, teria fornecido dados à OpenAI em iniciativas internas chamadas Project Taxi e Project Mango.
O Project Taxi teria disponibilizado material reunido para o índice do Bing. Já o Project Mango envolveu um crawler operado pela Microsoft para coletar páginas destinadas à OpenAI.
Segundo os autores da ação, o conjunto produzido a partir do Project Mango incluía cópias de pelo menos 160.903 obras únicas dos veículos envolvidos no processo.
O caso chama atenção justamente porque a Microsoft mantém uma relação histórica muito próxima com a OpenAI, embora nos últimos anos tenha ampliado o desenvolvimento de modelos próprios. O Overdrive já mostrou como a Microsoft começou a criar suas próprias IAs para reduzir a dependência da OpenAI.
Documento também cita tentativa de contornar paywall
Outro trecho delicado envolve o acesso a reportagens protegidas por paywall.
A petição afirma que funcionários da OpenAI discutiram uma maneira de acessar conteúdo do The New York Times contornando o paywall durante processos de coleta de dados.
Em uma dessas conversas, o pesquisador Nick Ryder teria mencionado a técnica a Greg Brockman, presidente da OpenAI. Brockman respondeu apenas “ah nice”.
O material também afirma que conjuntos utilizados durante o desenvolvimento dos modelos passaram por procedimentos que removiam avisos de copyright antes de os dados chegarem ao modelo.
São alegações particularmente relevantes porque a disputa sobre como empresas podem utilizar conteúdo disponível na internet para treinar IA continua sem uma resposta única nos tribunais americanos.
Satya Nadella falou sobre conteúdo atrás de paywall
O CEO da Microsoft, Satya Nadella, também aparece nos documentos, mas não como autor da frase sobre “roubo de trabalho”.
Em depoimento citado na ação, Nadella afirmou que conteúdo protegido por paywall deveria ser licenciado por quem pretende utilizá-lo para treinamento ou para fornecer informações aos sistemas.
Ele também teria declarado que, se soubesse que a OpenAI havia coletado e utilizado conteúdo protegido por paywall no treinamento, poderia ter usado os direitos previstos no acordo entre as empresas para exigir um novo treinamento dos modelos.
Isso não representa uma admissão da Microsoft de que o treinamento descrito no processo foi ilegal. A companhia diferencia esses princípios gerais da questão jurídica que está sendo julgada.
Microsoft viu risco de IA diminuir visitas aos próprios sites que produzem conteúdo
Há outro ponto especialmente relevante para sites, jornais e criadores.
Segundo a petição, dados internos da Microsoft mostrariam quedas expressivas na taxa de cliques para sites jornalísticos quando respostas produzidas por inteligência artificial eram apresentadas no lugar da busca tradicional.
Em alguns casos envolvendo conteúdos do New York Times e do Daily News, a redução apontada chegaria a uma faixa de 83% a 93%.
Um documento interno da Microsoft teria descrito esse cenário como um possível ciclo negativo: menos tráfego reduz os recursos disponíveis para produzir novos conteúdos, o que, por consequência, também diminui a quantidade e a qualidade de material disponível para futuros sistemas de IA.
É uma discussão que vai muito além de Microsoft e OpenAI. Ferramentas como ChatGPT, Gemini e mecanismos de busca com respostas geradas por IA estão mudando a forma como usuários chegam às páginas originais. O Overdrive mantém uma área dedicada às principais mudanças em inteligência artificial. Microsoft investe em modelos próprios de IA ao mesmo tempo em que mantém produtos e infraestrutura ligados à OpenAI. Imagem: Microsoft
O que a Microsoft respondeu?
A Microsoft contestou a interpretação de que as declarações representem uma admissão da empresa.
O porta-voz Alex Haurek afirmou que os comentários de Brent Hecht representam a perspectiva individual de um funcionário, não constituem uma análise jurídica e não representam a posição oficial da Microsoft.
A empresa continua defendendo que o uso de conteúdo no treinamento de modelos pode ser protegido por fair use, argumento jurídico que permite determinados usos de material protegido por direitos autorais sem autorização prévia.
A Microsoft também sustenta que produtos como o Copilot não substituem o jornalismo produzido pelos veículos.
A OpenAI não havia apresentado uma resposta pública específica aos novos trechos quando as primeiras reportagens sobre os documentos foram publicadas.
O tribunal já decidiu que houve roubo?
Não. Esse ponto é fundamental.
A expressão “maior roubo de trabalho da história da humanidade” é uma declaração atribuída a Brent Hecht em comunicação interna. Ela não é uma conclusão do tribunal.
Da mesma forma, os números e episódios revelados agora fazem parte dos argumentos apresentados pelos veículos que processam Microsoft e OpenAI.
O processo, identificado como In Re: OpenAI, Inc. Copyright Infringement Litigation, reúne diferentes ações no Tribunal Federal do Distrito Sul de Nova York e ainda discute quais acusações poderão seguir para julgamento.
Outra ressalva é importante: embora vários trechos antes ocultos tenham sido tornados públicos, parte dos documentos originais usados como evidência continua sob sigilo. Isso significa que algumas das citações divulgadas aparecem na petição dos autores sem todo o contexto dos anexos de onde foram retiradas.
Por que o caso pode mudar a indústria de IA?
O centro da disputa é definir até onde vai o direito de empresas de inteligência artificial de utilizar material protegido por copyright para criar modelos comerciais.
Microsoft e outras companhias argumentam que o treinamento é transformativo e pode se enquadrar em fair use. Publishers e criadores sustentam que copiar suas obras sem autorização e depois criar produtos capazes de responder às mesmas necessidades do usuário prejudica economicamente o mercado original.
Uma decisão definitiva pode afetar desde grandes laboratórios de IA até jornais, sites, escritores, programadores, artistas e praticamente qualquer indústria cuja produção tenha sido incorporada a grandes bases de treinamento.
A Microsoft, enquanto isso, continua aumentando sua presença direta no setor. Além da parceria histórica com a OpenAI, a empresa já desenvolve modelos próprios da família MAI e mantém uma página dedicada às suas novidades no Overdrive.
Perguntas frequentes
A Microsoft chamou o treinamento de IA de roubo?
Não como posição oficial da empresa. A frase foi atribuída a Brent Hecht, diretor de Applied Science da Microsoft, em uma comunicação interna. A Microsoft afirma que a declaração representa a opinião individual dele.
Quem disse “maior roubo de trabalho da história da humanidade”?
A frase foi atribuída a Brent Hecht, Partner Director of Applied Science da Microsoft.
O tribunal já decidiu que Microsoft ou OpenAI violaram direitos autorais?
Não em relação às alegações reveladas agora. O processo continua e os novos documentos fazem parte da disputa sobre quais acusações e argumentos prevalecerão.
A OpenAI teria usado conteúdo atrás de paywall?
Os autores do processo afirmam que documentos internos mostram discussões sobre maneiras de contornar o paywall do The New York Times durante a coleta de dados. A questão faz parte das alegações ainda em disputa judicial.
O que são Project Taxi e Project Mango?
Segundo os documentos judiciais, eram iniciativas da Microsoft relacionadas ao fornecimento ou coleta de grandes quantidades de páginas para uso pela OpenAI. O Project Taxi envolveria dados derivados do índice do Bing, enquanto o Project Mango utilizaria um crawler operado pela Microsoft.

Comentários